Umami auto-hébergé sur Coolify pour suivre événements et campagnes
Logo d’Umami, tiré du dépôt umami-software/umami (licence MIT).
Sur FitHere, on devait répondre à trois questions. Combien de personnes regardent un événement donné. Combien se convertissent, en le rejoignant ou en créant un événement. Et quelle campagne de promotion amène les gens qui viennent vraiment. C’était tout le cahier des charges côté analytics.
Pourquoi pas Google Analytics
Google Analytics sait tout faire, en théorie. En pratique c’est devenu une usine à gaz : pour trouver un chiffre il faut passer par trois menus, et ce n’est pas toujours le chiffre qu’on croyait regarder. Il n’est pas non plus très à l’aise avec le RGPD, ce qui pose problème quand les utilisateurs sont des organisateurs en France et à Taïwan.
Je suis donc parti chercher autre chose.
Plausible, Matomo et celui qui était trop
Plausible et Matomo ressortent en premier, et les deux sont compatibles RGPD. Il y en avait un troisième, PostHog, qui fait beaucoup plus que ce dont j’avais besoin et qui avait l’air lourd à monter sur mon propre serveur. Je ne m’y suis même pas mis.
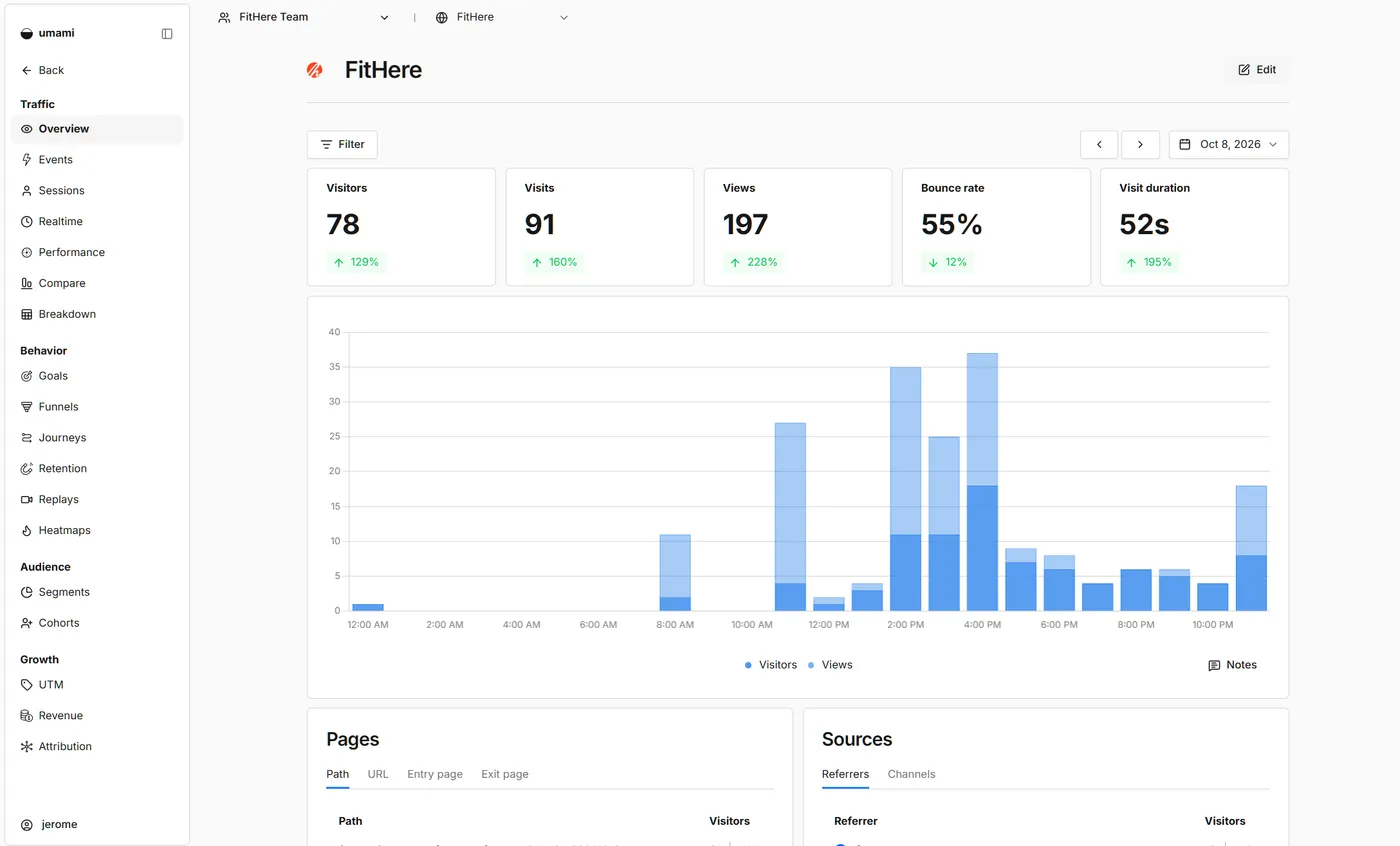
C’est Claude qui m’a recommandé Umami. Je l’ai regardé et ce qui m’a frappé en premier, c’est sa simplicité. Le tableau de bord est lisible, ce que Google Analytics ne sait plus faire. Le projet est assez récent mais il avance vite, ce que je compte comme un plus. Et il est auto-hébergé, donc les données restent sur mon serveur.
Ce que « compatible RGPD » veut dire ici
J’ai déjà dit deux fois « compatible RGPD », voici ce que j’entends. Umami ne pose aucun cookie. Il utilise l’IP du visiteur, le User-Agent et l’id du site pour calculer un hash qui identifie la session, et l’IP elle-même n’est jamais stockée : la table des sessions n’a pas de colonne pour elle. Mon API envoie bien cette IP à Umami, on le verra plus bas, mais seulement pour qu’elle y soit hachée. Umami me donne aussi moins de choses que Google, et pour ce projet, moins est la bonne quantité.
L’installer sur Coolify
Tout tourne déjà sur une instance Coolify, sur un VPS OVH : l’API, le worker, les sites. Umami y a rejoint le reste en tant que service Coolify prêt à l’emploi. Quelques clics et il tournait. Cette partie m’a pris moins de temps que la lecture des comparatifs.
J’aurais pu prendre Umami Cloud, et je ne l’ai pas fait, pour deux raisons. Côté RGPD, c’est plus simple de dire que les données ne quittent jamais un serveur que je gère. Et le plan gratuit de Cloud s’arrête à 100 000 événements par mois et un seul site, avec l’accès à l’API et au MCP réservé au plan payant. J’avais déjà un serveur, donc j’aurais payé pour quelque chose que j’avais.
Le vrai travail, ce sont les événements
L’installation est simple. Ce qui prend du temps, c’est de décider quoi mesurer, puis de l’écrire. Un outil d’analytics sans événements personnalisés te dit seulement que des gens sont venus.
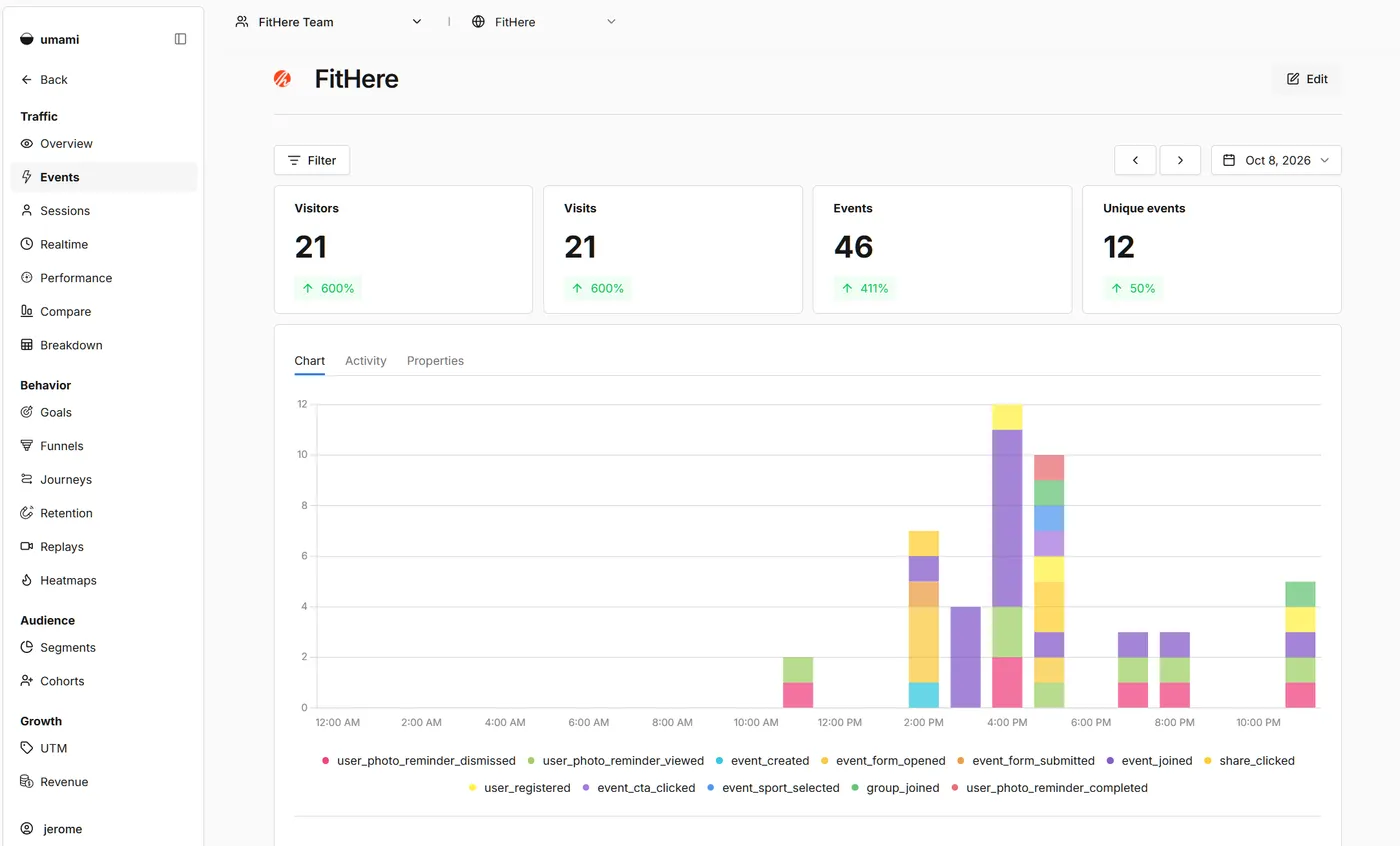
J’ai ajouté des événements sur les étapes qui comptent : créer un événement, en rejoindre un. Certains partent du navigateur, ce qui est la façon habituelle. Le souci, c’est que les adblocks bloquent le script Umami, et chaque événement avec lui. Les événements les plus importants partent donc du back. Un adblock ne voit pas ce qui se passe entre mon API et mon Umami.
Un visiteur, deux sessions
Ça a créé un autre problème. Umami construit une session à partir d’un hash de l’id du site, de l’IP du visiteur, du User-Agent et d’un sel qui tourne. Un événement envoyé par mon API arrive avec l’IP du serveur API, donc Umami le rangeait dans une session à part : une session fantôme, à Singapour, sans aucune page vue, même quand le visiteur était à Taïwan. La page vue venait du navigateur, la participation venait de nulle part, et le funnel cassait entre les deux.
Mon premier essai a été de transmettre l’IP du visiteur dans X-Forwarded-For et X-Real-IP. Ça n’a rien changé. Umami place les headers posés par un proxy (cf-connecting-ip, x-real-ip) au-dessus de x-forwarded-for, donc chaque événement gardait l’IP de l’API.
Ce qui marche : Umami lit ip et userAgent dans le payload en premier, et ne regarde les headers que s’ils sont absents. L’API met donc l’IP et le User-Agent réels du visiteur dans le payload :
return {
    website: this.websiteId,
    name: event.name,
    data: event.data ?? {},
    hostname: event.hostname ?? DEFAULT_PAGE.hostname,
    language: event.language ?? DEFAULT_PAGE.language,
    url: event.url ?? DEFAULT_PAGE.url,
    userAgent: event.userAgent ?? FALLBACK_USER_AGENT,
    ...(event.ip && { ip: event.ip }),
};
Les valeurs viennent de la requête du visiteur, récupérées par un décorateur sur les controllers. Même principe pour le hostname, l’URL et la langue, pris dans Referer et Accept-Language, pour que l’événement atterrisse sur la page où se trouvait vraiment le visiteur. Les valeurs en dur ne servent que de fallback pour les événements hors requête, comme un cron. Si un controller oublie le décorateur, l’événement arrive quand même dans Umami, en session orpheline, ce qui le rend facile à rater.
Celui-là a duré. Il a fallu un moment pour confirmer qu’il se produisait vraiment, puis le corriger, puis vérifier que la correction tenait. Les chiffres restaient exploitables entre-temps, mais pas propres.
Les visiteurs dans Umami, les participations dans la base
Avec le temps, Umami est entré plus profondément dans le projet, parce qu’on a commencé à construire un outil de suivi des événements. Deux besoins en sont sortis.
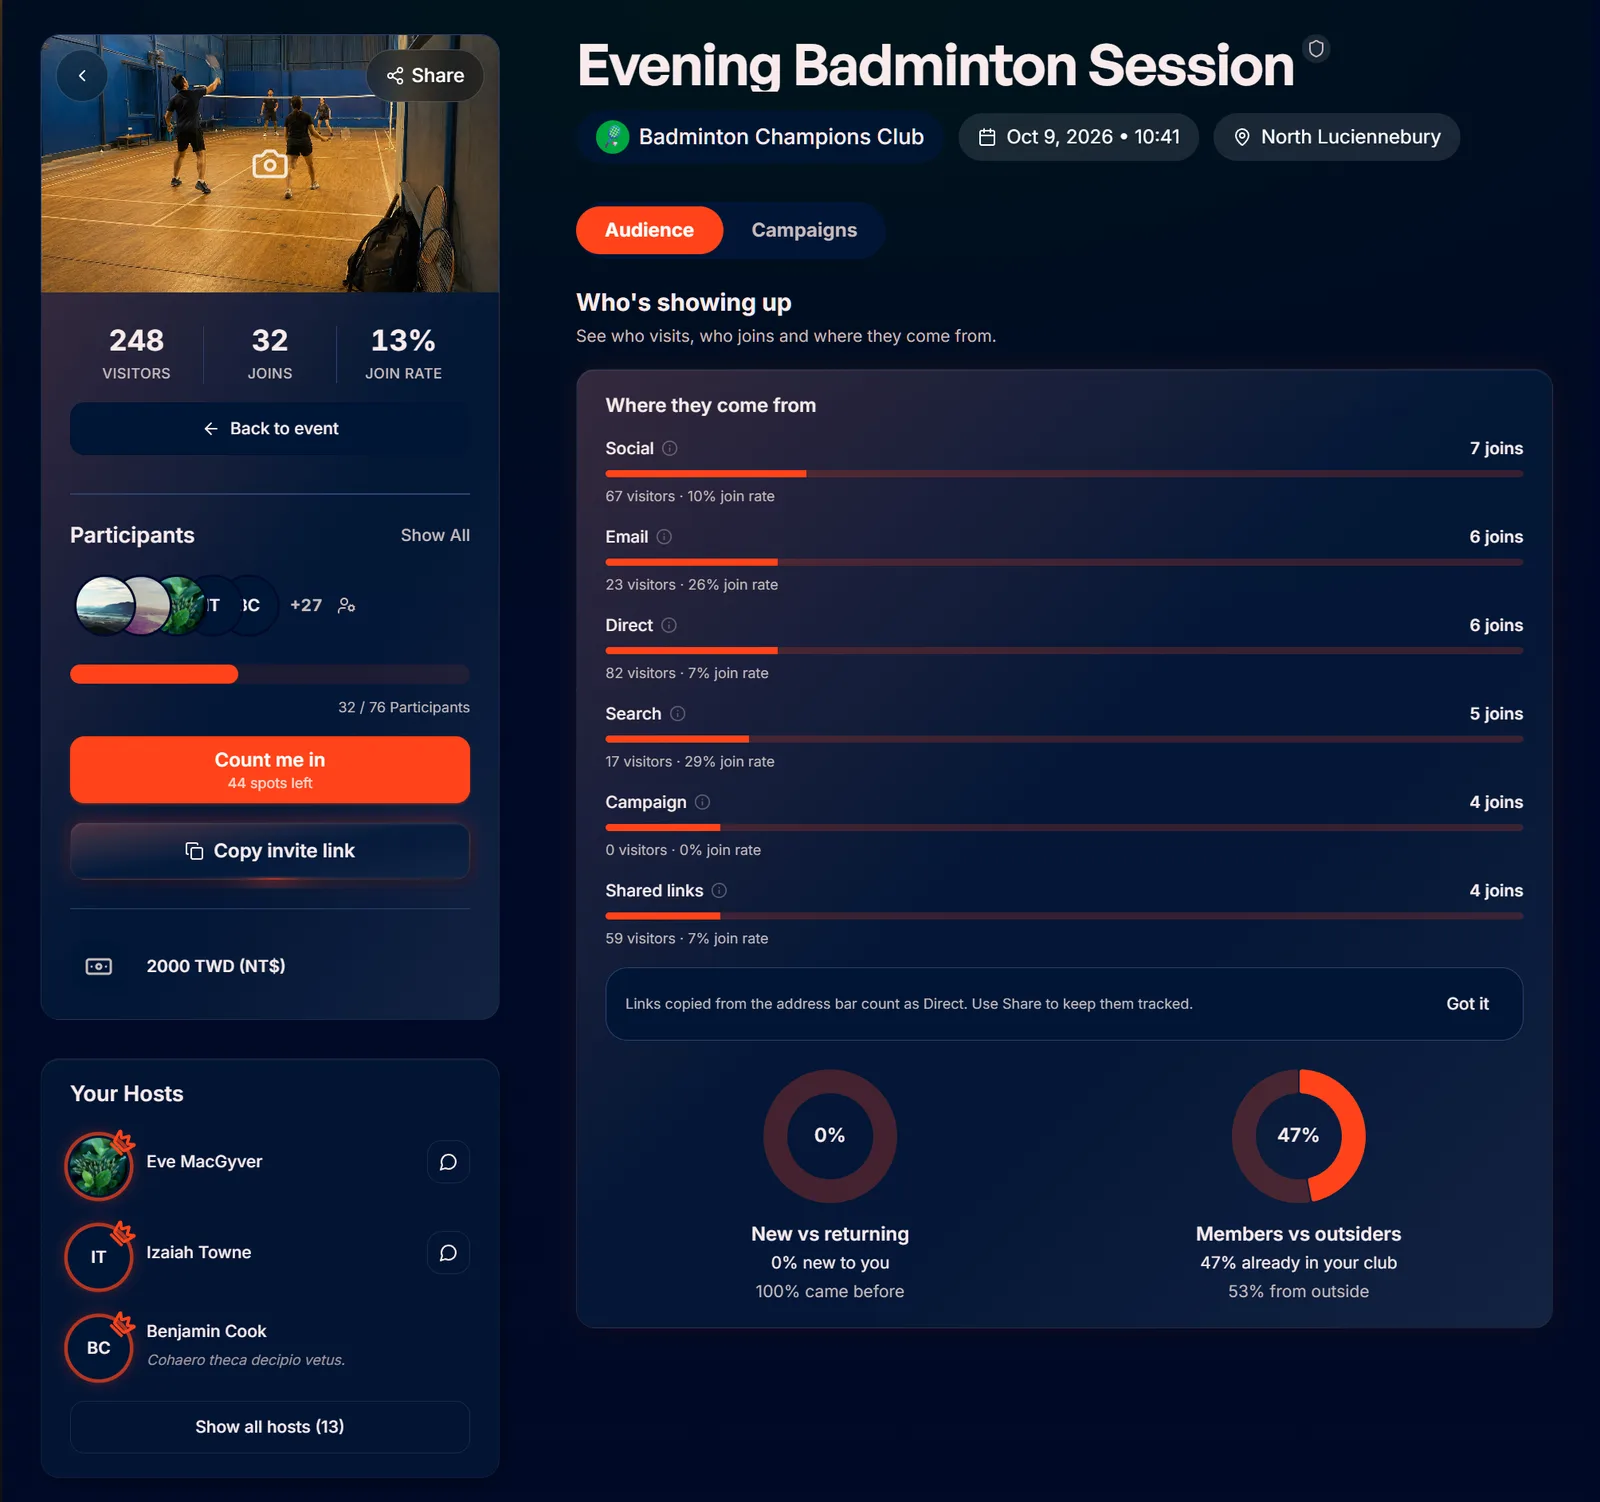
Le premier est simple : combien de visiteurs a eu la page d’un événement. Le second concerne les organisateurs. Quand quelqu’un lance une campagne pour son événement, sur un canal et à une date donnés, il veut savoir laquelle performe : combien de clics elle a générés, et combien de personnes ont rejoint grâce à elle.
Umami s’occupe des visiteurs. Les participations viennent de la base de données, et c’est elle qui fait foi. Compter les participations à partir des événements Umami donnerait un mauvais chiffre. Umami garde chaque événement de participation, y compris ceux des gens qui ont annulé puis rejoint à nouveau, et il ne sait pas filtrer un événement sur deux propriétés à la fois, ce dont une répartition par campagne et par canal a besoin. En base, une participation est une seule ligne et une personne qui a annulé n’est plus comptée, c’est donc ce chiffre-là que je crois.
Les campagnes fonctionnent comme ça. Quand quelqu’un arrive par le lien d’une campagne, on garde les paramètres UTM du lien dans son session storage. Quand il rejoint l’événement, ces paramètres sont enregistrés en base avec la participation. Chaque moitié répond donc à la question pour laquelle elle est bonne : Umami dit combien de personnes sont venues et d’où, la base dit combien ont rejoint.
Mis bout à bout, ça donne la page de suivi que voient les organisateurs pour chaque événement :
Umami fait partie de mon flow avec l’IA
Umami Cloud a son serveur MCP, mais je suis en auto-hébergé, donc j’ai écrit un petit script qui expose l’API d’Umami en serveur MCP en lecture seule. L’agent avec lequel je travaille peut ensuite lire les données lui-même. J’en ai un dédié à l’analytics, qui lit le trafic, les événements et les derniers chiffres.
Du coup je n’ai plus besoin de quitter mon travail pour aller voir les chiffres. Quand je suis sur un sujet UI ou UX, je demande à l’agent sur quoi les gens cliquent sur cette page et où ils décrochent, et je continue. Avant, ça voulait dire quitter ce que j’étais en train de faire, ouvrir le dashboard, oublier ce que je cherchais, et souvent remettre à plus tard. Maintenant la question coûte une phrase, donc je la pose plus souvent, et la réponse arrive pendant que je suis encore sur l’écran.